Datamodel bouwen: Star vs Snowflake
Je begrijpt het verschil tussen een star- en snowflake schema en kunt een betrouwbaar datamodel opzetten.
Je kunt tabellen koppelen met de juiste relaties en een STAR Schema opzetten.
Je hebt je data netjes opgehaald en opgeschoond in Power Query. Alles lijkt klaar om visuals te maken. Maar zodra je filters gebruikt of meerdere tabellen combineert, kloppen de cijfers ineens niet meer. Herkenbaar?
Dat komt bijna altijd door een fout in het datamodel. En daar gaan we het nu over hebben.
Power BI werkt namelijk anders dan Excel. In Excel kun je alles in één grote tabel proppen. In Power BI bouw je een model met feiten en dimensies, die je koppelt via relaties. Als je die relaties verkeerd legt, gaat je analyse onderuit, ook al lijkt het dashboard goed.
"Power BI laat het toe… tot je publiceert en iemand filtert op jaar. Dan zie je ineens dubbele omzet."
Feitentabellen en dimensietabellen
Eerst het verschil:
- Feitentabel = transacties, gebeurtenissen, meetbare dingen. Bijvoorbeeld: verkoopregels, facturen, boekingsregels.
- Dimensietabel = beschrijvende info. Bijvoorbeeld: klanten, producten, kalender, medewerkers.
Kun je het tellen, sommeren of berekenen? Feit. Beschrijft het wat, wie, waar of wanneer? Dimensie. Twijfel je? Dan is het meestal een dimensie, feiten zijn vrijwel altijd transactioneel.
Een stermodel is een eenvoudige datamodelstructuur waarin één centrale feitentabel omringd wordt door verschillende dimensietabellen. De feitentabel bevat kwantitatieve gegevens (zoals verkopen, kosten of aantallen), terwijl de dimensietabellen context bieden voor deze gegevens (zoals tijd, product of klant).
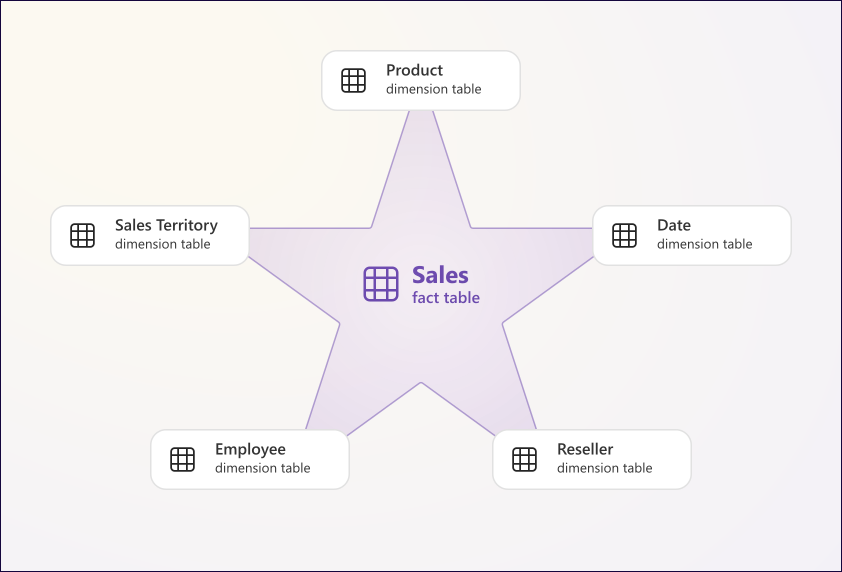
Kenmerken van het stermodel
- Eenvoudige structuur: gemakkelijk te begrijpen en te implementeren.
- Directe relaties: de feitentabel heeft directe relaties met elke dimensietabel, wat leidt tot snellere queryprestaties.
- Optimale prestaties: door de eenvoud van het model zijn er minder relaties nodig tijdens het uitvoeren van queries.
Voorbeeld van een stermodel
Je werkt met verkoopgegevens. Je hebt een feitentabel genaamd Verkoop, die informatie bevat zoals Verkoopbedrag, Aantal en KlantID. Ook heb je dimensietabellen zoals Klanten, Producten en Tijd. Elke dimensietabel biedt aanvullende context voor de verkoopdata.
Je model begint altijd bij de feitentabel. Die koppel je aan de dimensies via unieke sleutels. Zo krijg je een Star Schema: één centrale tabel, met stralen naar de rand. Star Schema = stabiel, snel en betrouwbaar.
Normalisatie en denormalisatie, wat is het en waarom moet je dit snappen
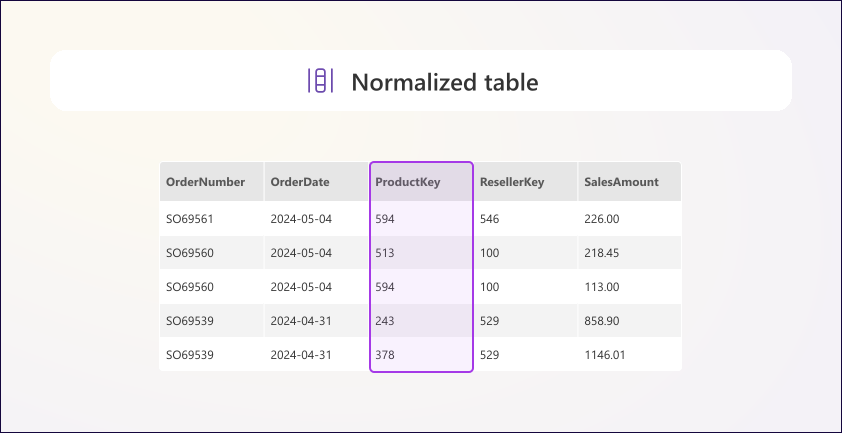
Normalisatie betekent dat je data opsplitst in logische tabellen. Elke tabel heeft één onderwerp en zo min mogelijk herhaling.
- Klanten in een klantentabel
- Producten in een producttabel
- Transacties in een feitentabel met sleutels
Dit zie je in bijna elk bronsysteem. Omdat het:
- Minder fouten oplevert
- Makkelijk te onderhouden is
- Efficiënt werkt voor databases
Verder lezen
Laat je naam en mailadres achter, dan lees je de rest
Je krijgt meteen de hele les, en alle andere lessen blijven daarna ook open. Geen wachtwoord, geen bevestigingsmail.
Denormalisatie is het tegenovergestelde. Je plakt informatie aan elkaar zodat alles in één tabel staat.
- Klantnaam staat op elke orderregel
- Productcategorie wordt telkens herhaald
- Regio staat in dezelfde rij als het bedrag
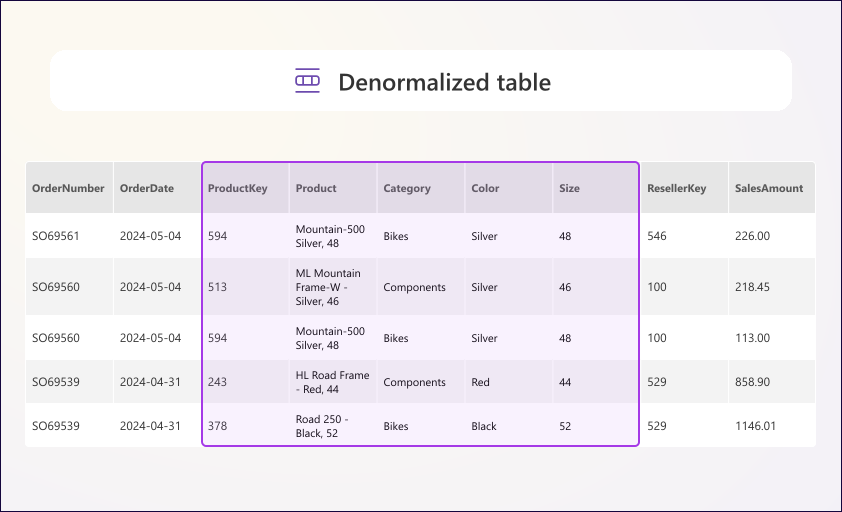
Dat leest lekker in Excel en voelt overzichtelijk. Totdat je gaat analyseren.
En daar komt Power BI om de hoek kijken. Power BI is een rekenmodel op basis van filtercontext. Dat werkt het best als:
- Bedragen op één plek staan
- Context (wie, wat, wanneer) los staat
- Filters gecontroleerd lopen van dimensie naar feit
Als je alles denormaliseert:
- Krijg je dubbele informatie
- Worden DAX-formules ingewikkelder dan nodig
- Kun je verkeerde totalen krijgen zonder het te merken
- Ga je performanceproblemen zien bij grotere datasets
Daarom is de praktijkregel in Power BI:
- Brondata mag genormaliseerd zijn
- Rapportdata modelleer je in een stermodel
- Denormaliseren doe je hooguit bewust en beperkt
Relaties leggen
Power BI maakt soms zelf relaties aan, maar die kloppen lang niet altijd. Controleer ze altijd in de Model View.
Belangrijke punten:
- Kies één-op-veel (1:*) vanuit de dimensie naar de feitentabel. Bijvoorbeeld: één klant → meerdere verkoopregels.
- Zet de filterrichting op "Single".
- Geen dubbele relaties tussen dezelfde tabellen: dan raakt Power BI in de war.
Later in deze module (les 1.7) gaan we dieper in waarom we streven naar één-op-veel (1:*) en single relaties.
Check:
- Is de sleutelkolom uniek in de dimensietabel?
- Zitten er geen nulls of lege waarden in?
- Is het datatype hetzelfde aan beide kanten?
In een stermodel heb je een feitentabel "Verkoopregels" en dimensietabellen "Klanten", "Producten" en "Datum". Welke tabel staat in het midden?
Star vs Snowflake, wanneer welke?
Sommige mensen maken een snowflake schema: een dimensietabel met z'n eigen subtabellen (bijvoorbeeld: producten → categorieën → leveranciers). Ziet er netjes uit, maar maakt je model onnodig complex voor de meeste Power BI-scenario's.
| Aspect | Star Schema | Snowflake Schema |
|---|---|---|
| Structuur | Plat: 1 niveau dimensies | Genest: dimensies met sub-tabellen |
| Aantal relaties | Minimaal | Veel |
| Query-performance | Snel (minder joins) | Trager (meer joins) |
| DAX-complexiteit | Laag | Hoger |
| Onderhoud | Eenvoudig | Lastiger |
| Best voor | Import-modus, BI-rapporten | Zeer grote datasets, DirectQuery |
| Microsoft-advies | Aanbevolen default | Alleen waar nodig |
Tenzij je echt grote datasets hebt of met specialistische berekeningen werkt: hou het bij een Star Schema.
"Klinkt theoretisch? In de praktijk gaat het hier mis."
Je hebt een relatie tussen Klanten (1) en Verkoopregels (*). In welke richting filtert deze relatie standaard?
Mini-verdieping: bidirectionele relaties
Soms zie je dat Power BI voorstelt om een bidirectionele relatie te maken. Klinkt handig, want dan filtert alles beide kanten op. Maar het is gevaarlijk.
Bidirectionele relaties:
- Leiden vaak tot cirkels in je model
- Maken DAX-formules moeilijker
- Kunnen leiden tot dubbele tellingen
Advies: gebruik dit liever niet, zorgt voor minder complexiteit.
Tips & checks uit de praktijk
- Begin bij de feitentabel en teken je model als een ster
- Check of je sleutels écht uniek zijn in de dimensietabellen
- Gebruik ID's om te koppelen, geen namen of omschrijvingen
- Zet bij voorkeur de filterrichting op "één kant op" (single)
- Nooit kolommen van verschillende types koppelen (tekst vs getal = fout)
Praktijkvoorbeeld
Je hebt drie tabellen:
- Verkoopregels met klant-ID en product-ID
- Klanten met klant-ID, naam en regio
- Producten met product-ID, naam en categorie
Op het oog klopt alles. Maar iemand heeft de klant-ID als tekst staan in Klanten, en als getal in Verkoopregels. Power BI kan dan géén relatie leggen.
Het lijkt alsof je model werkt, tot je filtert. Dan krijg je dubbele regels, lege visualisaties of verkeerde totalen.
Hoe je het voorkomt:
- Koppel altijd op unieke, stabiele ID's
- Controleer dat beide kolommen exact hetzelfde datatype hebben
- Gebruik de Model View om visueel te controleren of alles goed zit
- Test je relaties door een simpele tabelvisual te maken met een filter
- Download
dim_feit.pptxen benoem of elk blok een feit of dimensie is. - Open het Excel-bestand
Les-1.2-powerbi-oefenbestand.xlsx. - Leg relaties tussen deze tabellen: Verkoopregels → Klanten (via klant-ID), Verkoopregels → Producten (via product-ID).
- Ga naar de Model View en check: zijn alle relaties 1:* met de juiste filterrichting? Hernoem onduidelijke tabellen of kolommen. Test met een tabelvisual: toon omzet per klant, en filter op jaar.
- Een Star Schema heeft één feitentabel in het midden met dimensietabellen eromheen, eenvoudig, snel en het Microsoft-default.
- Feiten zijn meetbaar; dimensies zijn beschrijvend.
- Relaties leg je 1:* vanuit dimensie naar feit, met single filterrichting.
- Vermijd bidirectionele relaties en denormalisatie tenzij je er een specifieke reden voor hebt.
- Test je relaties altijd met een filtertest vóór je een rapport publiceert.
Reflectievraag
Gebruik jij in je werk nog Excel-tabellen zonder duidelijke relaties? Hoe zeker weet je dan dat je cijfers kloppen als je filtert of selecteert?
Wil je je voortgang bewaren, de oefenbestanden erbij en je inschrijven voor de gratis avond, maak dan een gratis account aan. Je hoeft alleen op een link in je mail te klikken.
Maak een gratis account